AI Agent tự chạy end-to-end: cần những guardrail nào trước production?
Framework guardrail thực tế để đưa AI Agent tự vận hành vào production: giới hạn phạm vi, policy, quyền, idempotency, ngân sách, quan sát, kill switch và rollout theo mức tự chủ.

AI Agent chỉ nên tự chạy end-to-end trên production khi quyền tự chủ đã được giới hạn bằng code và policy, mọi side effect đều có thể truy vết, chi phí và phạm vi ảnh hưởng bị chặn ở mức chấp nhận được, đồng thời đội vận hành có thể dừng hoặc hạ cấp agent mà không phụ thuộc vào chính model. Prompt tốt, confidence cao hay một vòng QA bằng LLM khác không đủ để trở thành guardrail production.
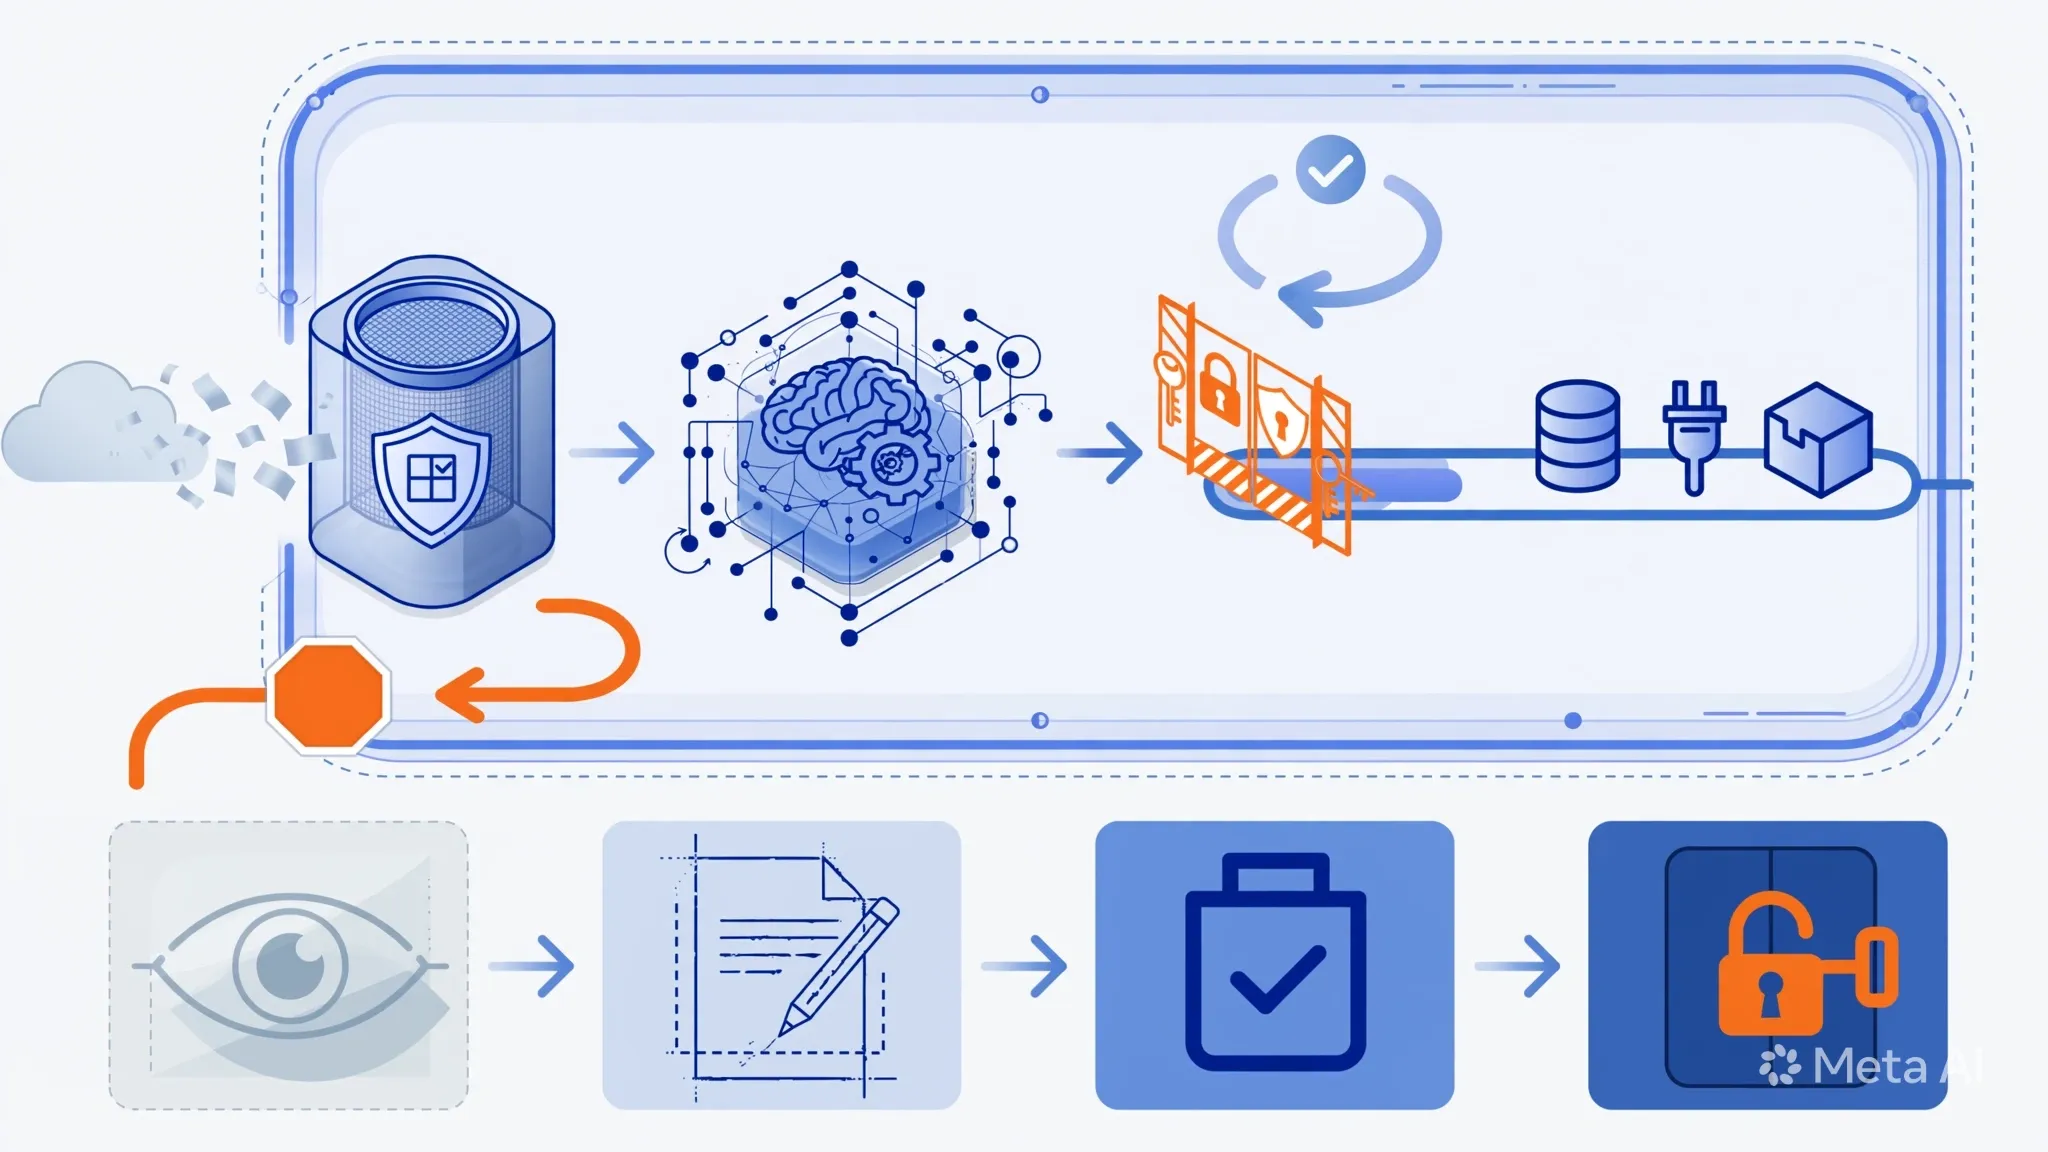
Mô hình thực tế là: input không tin cậy → agent đề xuất kế hoạch → policy độc lập quyết định → executor có quyền tối thiểu thực thi → hệ thống xác minh hậu điều kiện → giám sát liên tục → tự động dừng khi vượt ngưỡng. Hành động đọc hoặc tạo draft có thể tự động hoàn toàn; thanh toán, xóa vĩnh viễn, cấp quyền, gửi dữ liệu nhạy cảm hay deploy production phải có policy nghiêm hơn, approval ràng buộc hoặc bị cấm. Mục tiêu không phải loại bỏ mọi rủi ro, mà giữ residual risk trong ngưỡng doanh nghiệp đã phê duyệt.
Hiểu đúng
End-to-end không có nghĩa là giao toàn quyền cho model
Agent có thể tự hoàn thành workflow, nhưng quyền quyết định và quyền thực thi phải nằm ngoài LLM.
Một agent tự động thường nhận mục tiêu, đọc dữ liệu, lập kế hoạch, gọi nhiều tool, đánh giá kết quả và retry. Mỗi bước đều có thể hợp lệ riêng lẻ nhưng chuỗi tổng thể vẫn sai: lấy dữ liệu đúng người nhưng gửi nhầm kênh, retry một API không idempotent, hiểu sai trạng thái nghiệp vụ hoặc lặp cho đến khi vượt ngân sách. Prompt injection, dữ liệu RAG lỗi thời, tool response độc hại và model/provider thay đổi còn làm hành vi thay đổi ngoài dự kiến.