Chuẩn hóa knowledge base trước khi đưa vào RAG: quy trình tránh dữ liệu rác và câu trả lời sai
Quy trình thực tế để chuyển PDF, DOCX, TXT và Markdown thành knowledge base chuẩn, có metadata, kiểm soát chất lượng và sẵn sàng cho RAG.

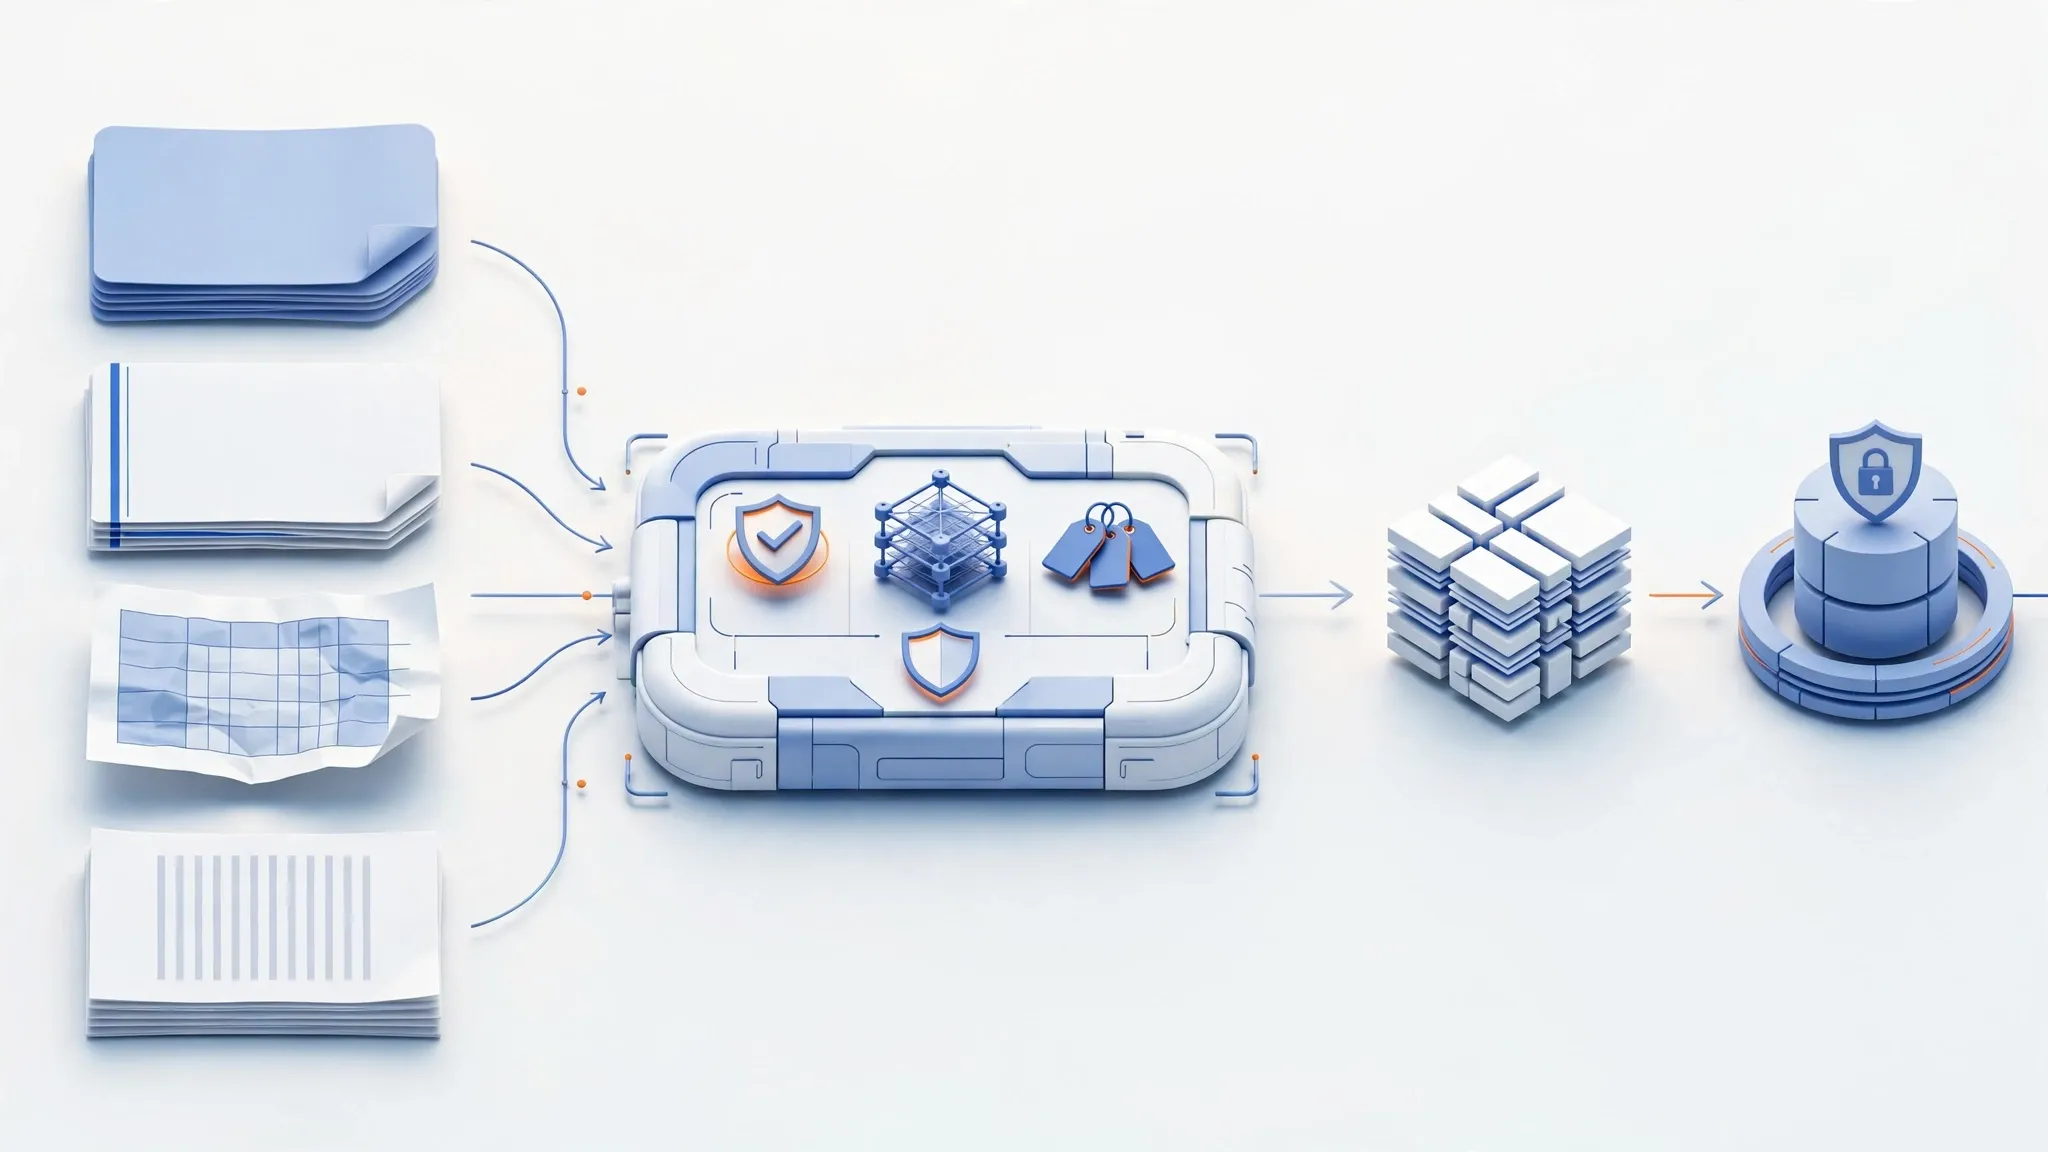
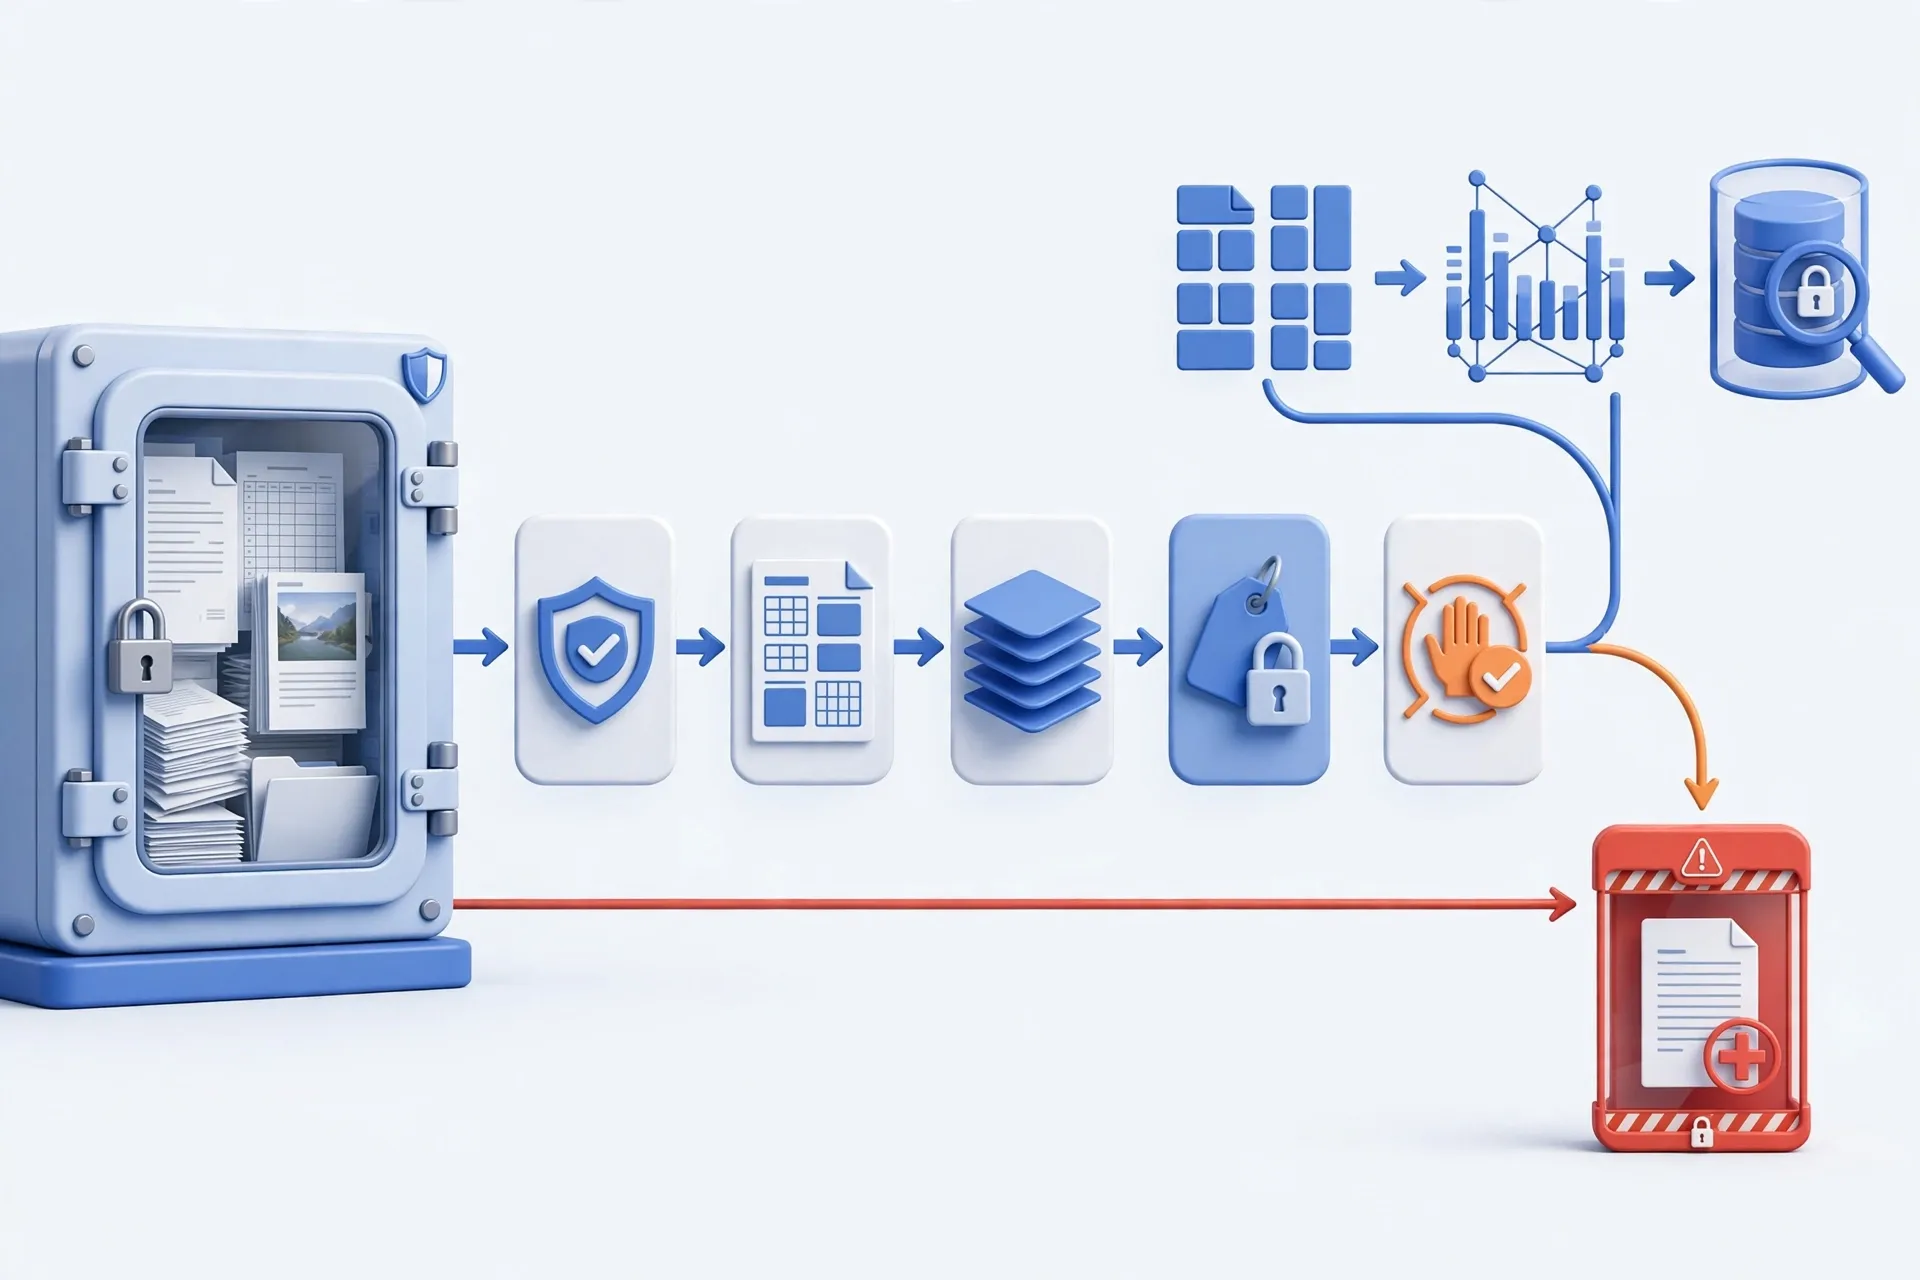
Một hệ thống RAG không thể trả lời ổn định nếu knowledge base chứa văn bản OCR lỗi, nội dung trùng, quy định hết hạn hoặc tài liệu của nhiều chi nhánh bị trộn lẫn. Cách đúng là không embedding tài liệu ngay sau khi upload. Hãy tạo một tầng chuẩn hóa nằm giữa nguồn thô và vector index: kiểm tra file, trích xuất cấu trúc, làm sạch có kiểm soát, gắn metadata và quyền truy cập, phát hiện xung đột, cho phép phê duyệt, rồi mới chunk và index.
Mục tiêu không phải biến mọi tài liệu thành văn bản đẹp. Mục tiêu là tạo ra một bản knowledge chuẩn có thể truy vết: biết thông tin đến từ đâu, có hiệu lực khi nào, áp dụng cho khách sạn hoặc chi nhánh nào và ai được phép truy xuất. Chunking chỉ nên bắt đầu sau khi bản chuẩn này vượt qua quality gate.
Vấn đề
Tại sao đưa tài liệu thô thẳng vào RAG thường thất bại?
Embedding không sửa được dữ liệu sai; nó chỉ giúp tìm lại dữ liệu đã được đưa vào index.
Dấu hiệu cảnh báo