Top-K càng cao, AI trả lời càng chính xác?
Top-K cao có thể tăng khả năng tìm thấy tài liệu đúng nhưng cũng đưa thêm nhiễu vào ngữ cảnh. Cách tune Top-K cho RAG bằng retrieval, reranking và evaluation.

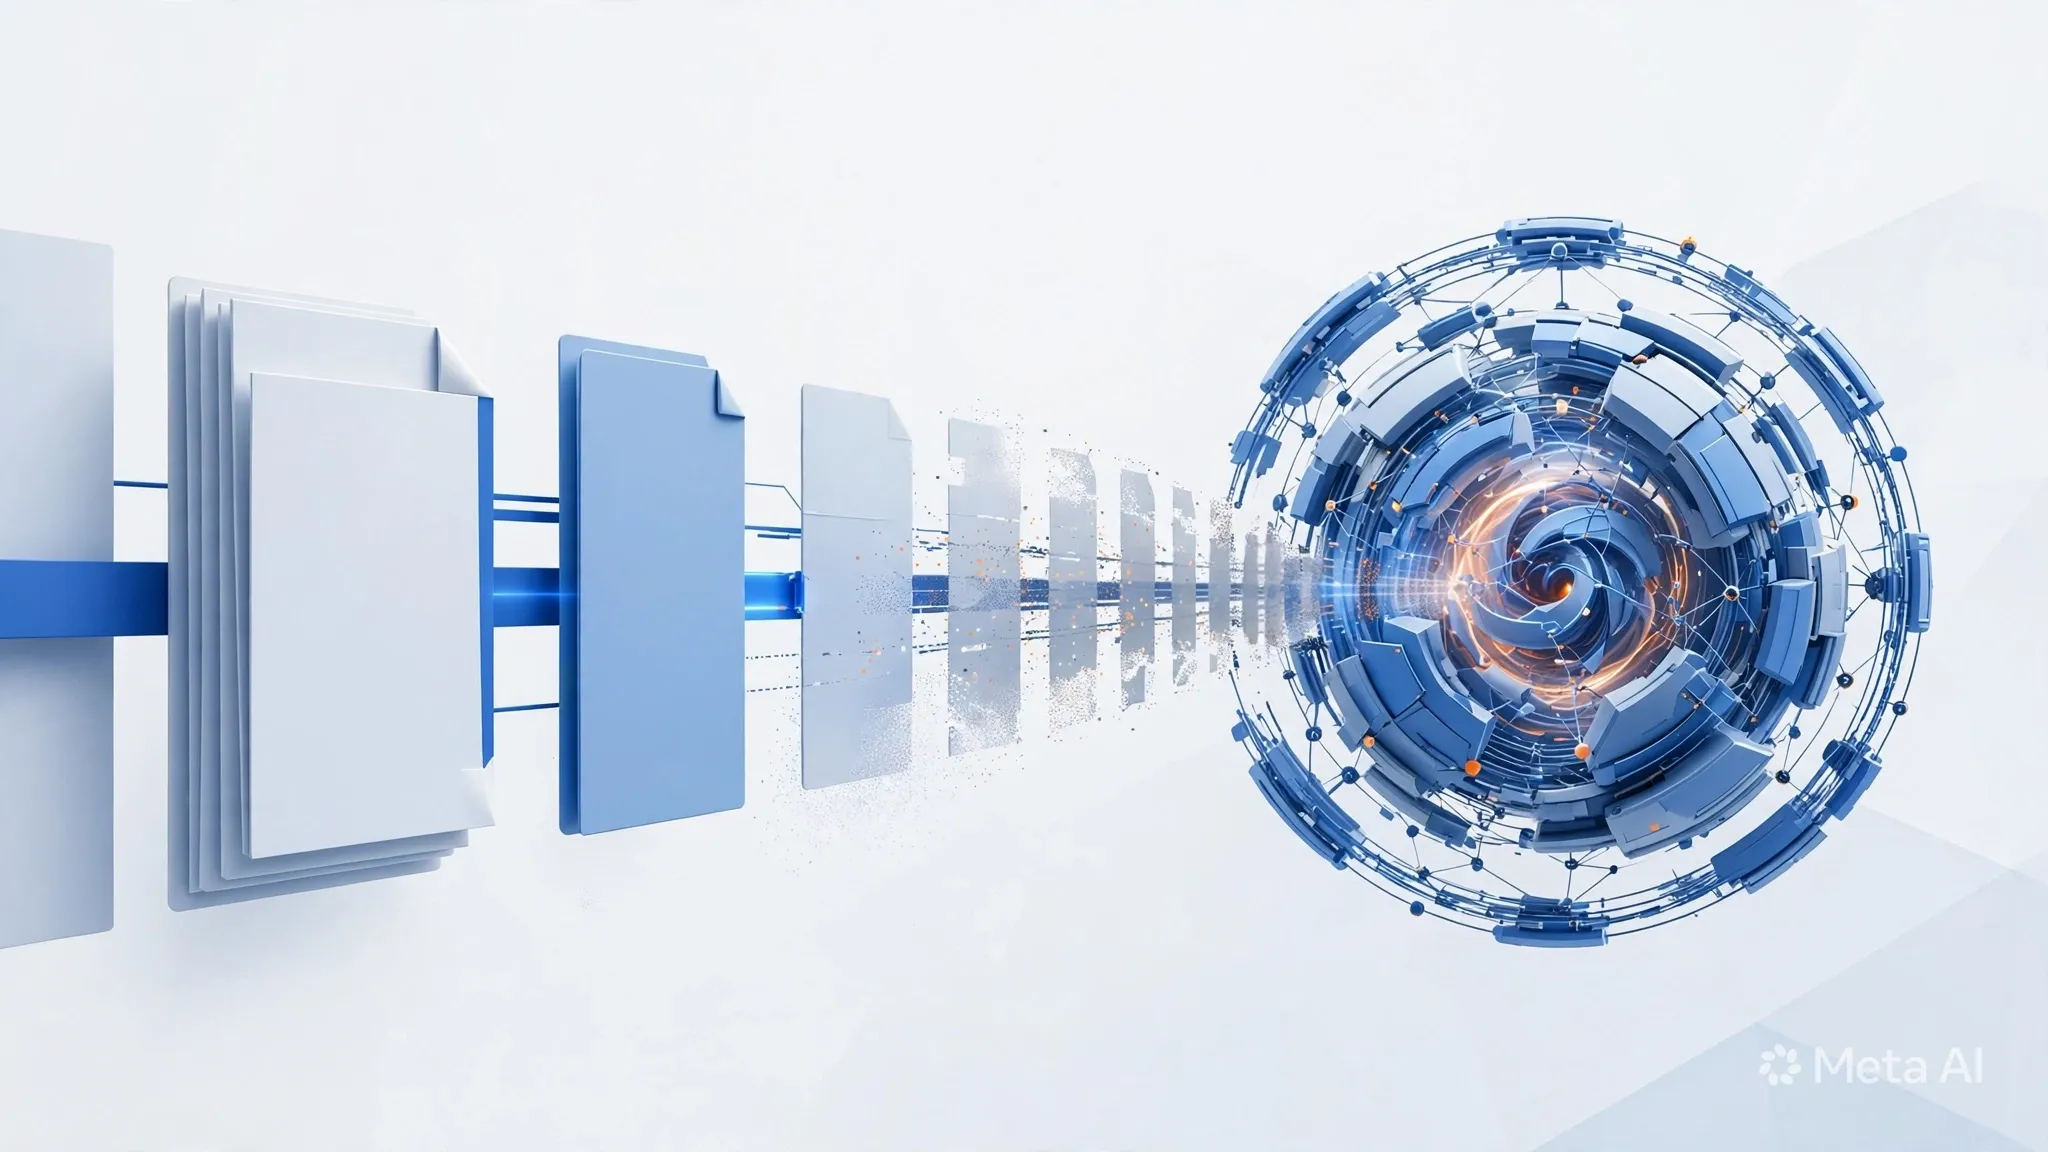
Không. Trong RAG, tăng Top-K không tự động làm AI trả lời chính xác hơn. K lớn hơn giúp bộ tìm kiếm lấy nhiều ứng viên hơn nên có thể giảm nguy cơ bỏ sót tài liệu liên quan. Nhưng nếu các kết quả bổ sung có chất lượng thấp, chúng lại làm context dài hơn, tăng nhiễu, tốn token và có thể khiến mô hình dựa vào thông tin kém liên quan.
Vì vậy câu hỏi đúng không phải là "K bao nhiêu là tốt nhất?" mà là "K nào tạo ra tập tài liệu đủ đầy nhưng vẫn tập trung cho loại câu hỏi và dữ liệu của mình?" Trong hệ thống production, nên tách K dùng để lấy candidate khỏi số chunk cuối cùng đưa vào LLM, sau đó tune bằng evaluation thay vì chọn một con số cố định theo cảm tính.
Nền tảng
Top-K trong RAG thực sự kiểm soát điều gì?
K là số kết quả retrieval được lấy ở một bước, không phải thước đo trực tiếp của độ chính xác câu trả lời.
Trong vector search, truy vấn được biểu diễn dưới dạng vector và hệ thống tìm các vector tài liệu gần nhất. Top-K thường chỉ số lượng kết quả gần nhất cần trả về. Với hybrid search, kết quả keyword và vector có thể còn được hợp nhất, xếp hạng và xếp hạng lại trước khi ứng dụng chọn context cho LLM.
Do đó cần phân biệt ít nhất hai lớp. Retrieval K quyết định độ rộng của tập ứng viên. Final context K là số chunk thật sự đi vào prompt sau filter hoặc reranking. Nếu đặt cả hai bằng một giá trị duy nhất, tăng K có thể vô tình biến mục tiêu "tìm rộng hơn" thành "nhét nhiều dữ liệu hơn vào model". Đây là hai bài toán khác nhau.