Chuẩn hóa website cho Google và AI Search: Bài học từ chính flownexa.ai
Google nói không cần file hay markup đặc biệt cho AI Overviews. Đây là năm lớp FlowNexa đã chuẩn hóa trên flownexa.ai: crawl, index, nội dung, dữ liệu có cấu trúc, tác giả thật, kèm những lỗi đã phải sửa.
Trả lời ngắn: Không có "mẹo" riêng cho AI Search. Google ghi rõ rằng không cần file, markup hay schema đặc biệt nào để xuất hiện trong AI Overviews và AI Mode; trang chỉ cần được index và đủ điều kiện hiển thị snippet. Thứ thực sự tạo khác biệt là nền tảng: crawl và index sạch, nội dung trả lời thẳng câu hỏi, dữ liệu có cấu trúc khớp với nội dung hiển thị, và tác giả, nguồn minh bạch.
Bài này không phải lý thuyết. Đây là những gì FlowNexa đã làm, và cả những lỗi đã phải sửa, khi chuẩn hóa chính website flownexa.ai: 117 cặp bài viết tiếng Việt và tiếng Anh, chạy trên Next.js, Strapi và Kubernetes. Bạn có thể dùng nó như một checklist cho website doanh nghiệp của mình.
Bối cảnh
Google nói gì về AI Overviews và AI Mode?
Tài liệu AI features and your website của Google Search Central trả lời ba câu hỏi mà nhiều doanh nghiệp đang lo:
- Có yêu cầu riêng không? Không. Google viết: không có yêu cầu bổ sung hay tối ưu đặc biệt nào để xuất hiện trong AI Overviews hoặc AI Mode. Điều kiện là trang được index và đủ điều kiện hiển thị kèm snippet trong Search.
- Có cần file hay markup mới không? Không. Google nói rõ không cần tạo file đọc bằng máy mới, file văn bản dành cho AI hay markup mới. Cũng không có schema.org đặc biệt nào cần thêm.
- Kiểm soát thế nào? Bằng robots.txt cho Googlebot, và các chỉ thị
nosnippet,data-nosnippet,max-snippet,noindex. RiêngGoogle-Extendedkhông điều khiển Search; nó chỉ giới hạn việc dùng nội dung trong một số hệ thống khác của Google.
Một khuyến nghị đáng chú ý: dữ liệu có cấu trúc phải khớp với nội dung hiển thị trên trang. Điều này quyết định cách chúng tôi thiết kế toàn bộ JSON-LD ở phần dưới.
Khung tư duy
Năm lớp nào giúp nội dung được tìm thấy và được trích dẫn?
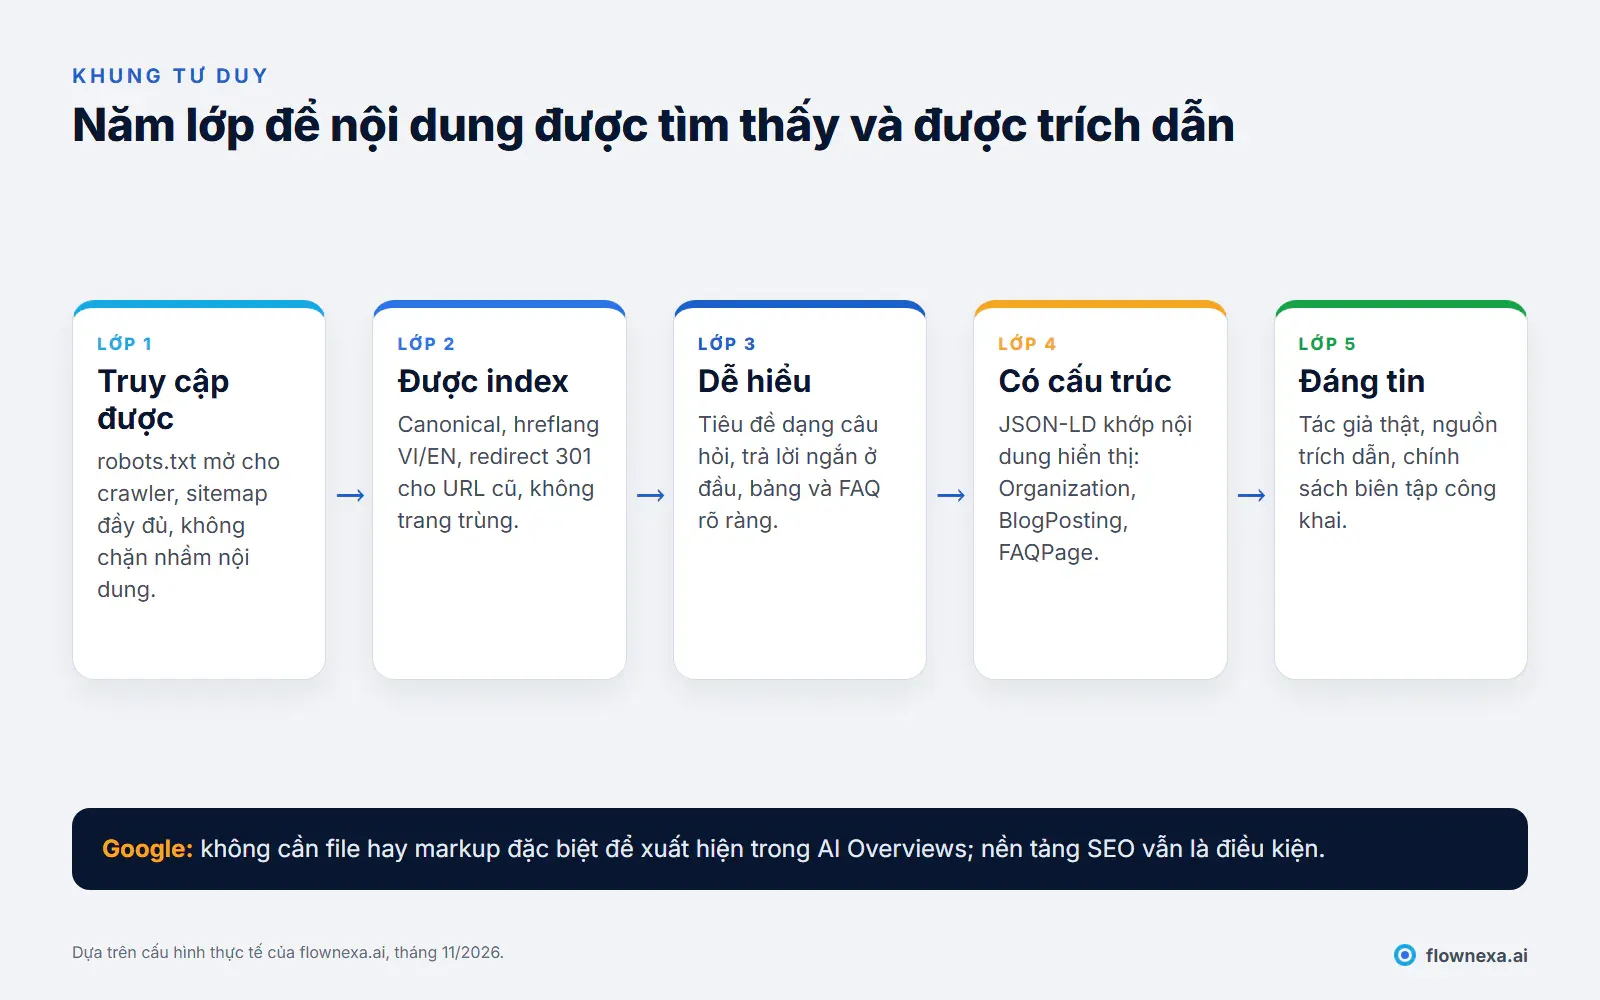
Chúng tôi chia công việc thành năm lớp. Lớp sau chỉ có tác dụng khi lớp trước đã ổn: dữ liệu có cấu trúc đẹp đến đâu cũng vô nghĩa nếu trang chưa được index.
Lớp 1–2
Crawl và index: nền móng không thể bỏ qua
robots.txt có chủ đích. Website cho phép các crawler của công cụ tìm kiếm và trợ lý AI (Googlebot, Bingbot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-SearchBot, PerplexityBot, Applebot…) và chỉ chặn khu vực /api/. Đây là lựa chọn kinh doanh: FlowNexa muốn nội dung được trích dẫn. Doanh nghiệp khác có thể chọn khác, nhưng nên quyết định có ý thức thay vì để mặc định.
Sitemap phản ánh nội dung thật. sitemap.xml liệt kê đủ trang tiếng Việt và tiếng Anh, kèm hreflang cho từng URL. Giá trị lastmod lấy từ ngày nội dung thay đổi thực chất, không phải ngày hệ thống ghi dữ liệu. Bài bị tạm giữ index (noindex) được loại khỏi sitemap.
Song ngữ đúng chuẩn. Mỗi bài có slug riêng cho /vi và /en, hreflang hai chiều và x-default trỏ về tiếng Việt, theo hướng dẫn localized versions của Google.
URL cũ không được chết. Khi gộp hoặc đổi slug, URL cũ được chuyển hướng 301 về bài thay thế. Hiện website quản lý 58 URL cũ như vậy trong code, có test kiểm tra.
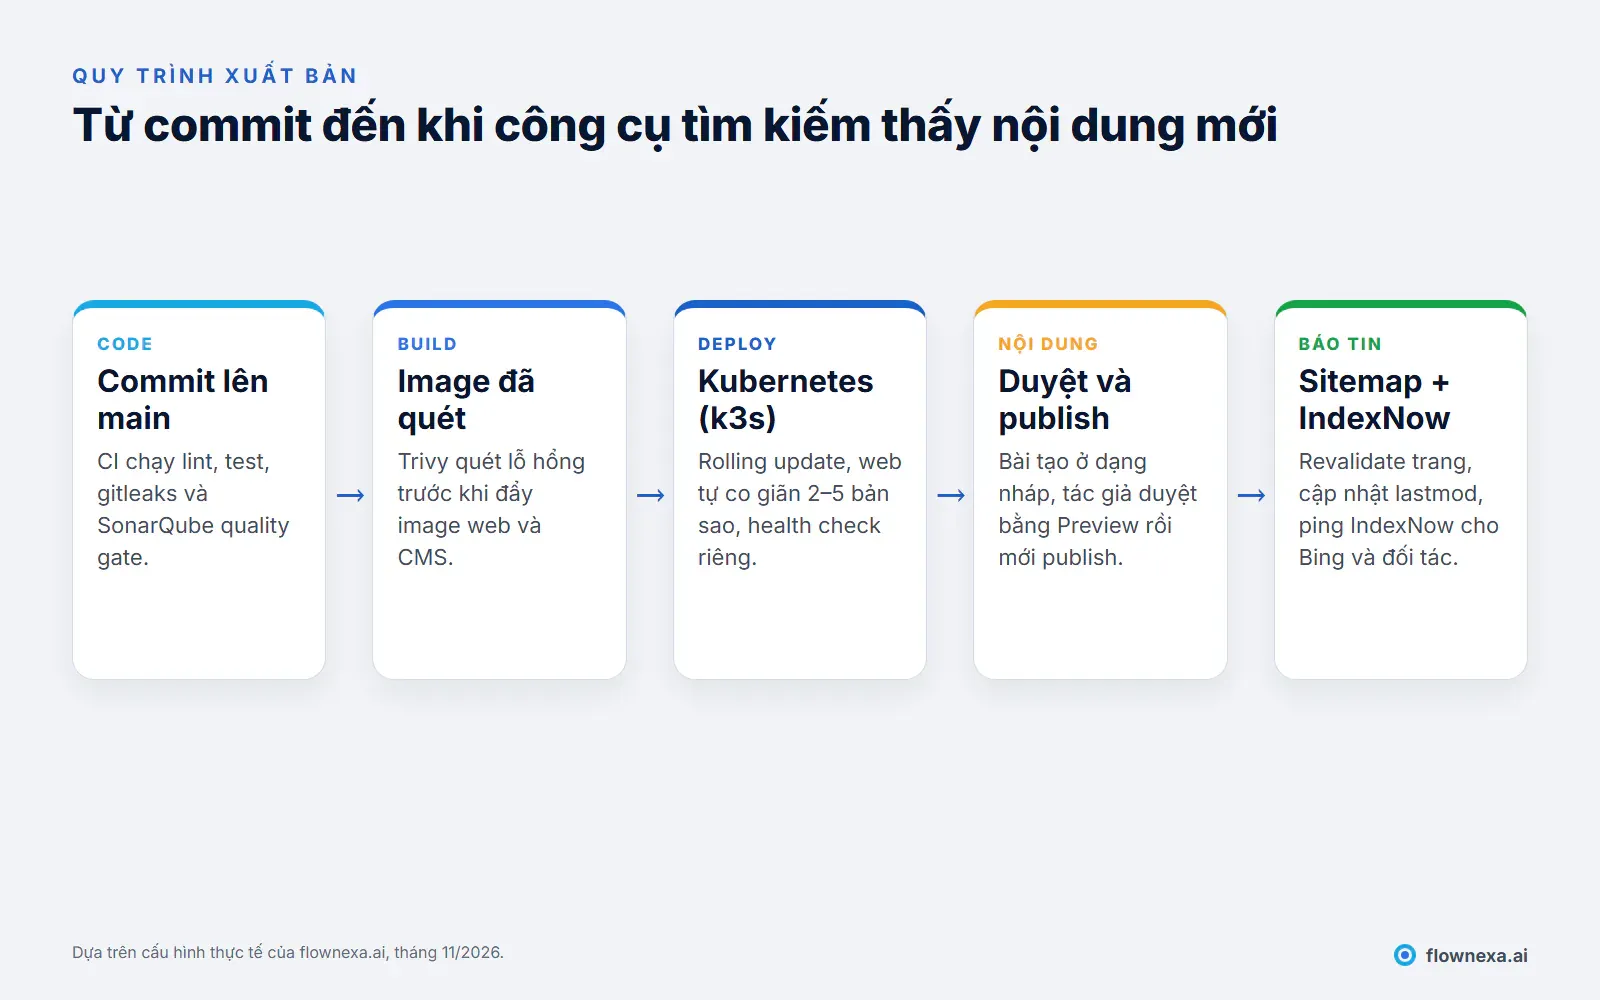
Báo tin khi xuất bản. Mỗi khi một bài được publish, website cập nhật lại trang và gửi URL qua IndexNow. Lưu ý: IndexNow được Bing, Yandex, Naver, Seznam, Yep và Amazon hỗ trợ; Google không nằm trong danh sách. Với Google, sitemap và Search Console vẫn là kênh chính.
Lớp 3
Nội dung dễ hiểu với cả người đọc lẫn máy
Hệ thống AI trích dẫn những đoạn trả lời rõ ràng. Vì vậy mỗi bài trên blog FlowNexa theo cùng một khuôn:
- Tiêu đề dạng câu hỏi thật mà khách hàng hay hỏi, ví dụ "Webhook gửi nhiều lần: làm sao chỉ xử lý một lần?".
- Đoạn trả lời ngắn ngay đầu bài, khoảng 40–60 từ, trả lời thẳng câu hỏi trước khi đi vào chi tiết.
- Mỗi tiêu đề H2 là một câu hỏi con, kèm bảng so sánh, checklist và phần câu hỏi thường gặp.
- Một ý định tìm kiếm, một bài. Khi review, chúng tôi phát hiện nhiều cặp bài cùng trả lời một câu hỏi, ví dụ hai bài về chuyển email on-premise lên Microsoft 365. Các bài này cạnh tranh từ khóa với nhau và làm loãng tín hiệu; cách xử lý là gộp nội dung và chuyển hướng 301.
Lớp 4
Dữ liệu có cấu trúc: chỉ mô tả những gì đang hiển thị
Website xuất JSON-LD cho các thực thể chính, và mọi giá trị đều lấy từ chính nội dung hiển thị:
| Schema | Dùng ở đâu | Nguồn dữ liệu |
|---|---|---|
Organization | Toàn site | Tên pháp nhân, mã số thuế, địa chỉ, người sáng lập |
BlogPosting | Mỗi bài viết | Tiêu đề, mô tả, ngày đăng, ngày cập nhật, tác giả |
Person | Tác giả bài viết, trang tác giả | Hồ sơ tác giả hiển thị trên trang |
FAQPage | Bài có phần FAQ | Trích trực tiếp từ các câu hỏi hiển thị cuối bài |
BreadcrumbList | Bài viết, trang con | Đường dẫn Trang chủ → Blog → Bài viết |
Về FAQPage: từ tháng 8/2023, Google chỉ hiển thị rich result dạng FAQ cho một số website chính phủ và y tế có uy tín. Chúng tôi vẫn giữ schema này vì nó mô tả đúng cấu trúc hỏi đáp cho mọi hệ thống đọc trang, và nó được sinh tự động từ chính phần FAQ hiển thị nên không bao giờ lệch nội dung.
Một chi tiết kỹ thuật nhỏ nhưng quan trọng: chuỗi JSON-LD được escape ký tự <, để nội dung từ CMS không thể vô tình đóng thẻ <script>.
Lớp 5
Tác giả thật và minh bạch về cách dùng AI
Đây là thay đổi lớn nhất trong đợt chuẩn hóa. Trước đây bài viết đứng tên "FlowNexa Team" hoặc "FlowNexa Editorial Team", trong khi thực tế không có một ban biên tập như vậy. Hiện tại:
- Mọi bài đứng tên người chịu trách nhiệm thật, có trang hồ sơ tác giả với kinh nghiệm và chứng chỉ, liên kết với thực thể
Organizationqua thuộc tínhfounder. - Cuối mỗi bài có dòng công khai rằng bài được biên soạn với sự hỗ trợ của AI và được kiểm tra kỹ thuật trước khi xuất bản.
- Chính sách biên tập mô tả quy trình: AI hỗ trợ soạn nháp, bài chỉ ở trạng thái nháp cho đến khi được duyệt, mọi số liệu và giá phải được kiểm chứng và dẫn nguồn, không bịa case study.
Lý do rất thực tế: hệ thống tìm kiếm và người đọc đều cần biết ai chịu trách nhiệm cho nội dung. Một cái tên chung chung không trả lời được câu hỏi đó.
Về llms.txt
Có nên tạo file llms.txt không?
llms.txt là một đề xuất cộng đồng do Jeremy Howard công bố tháng 9/2024, chưa phải tiêu chuẩn chính thức như robots.txt. Như đã dẫn ở trên, Google nói không cần file văn bản dành cho AI để xuất hiện trong các tính năng AI của Search.
flownexa.ai vẫn có file /llms.txt vì hai lý do: chi phí duy trì gần như bằng không, và nó là một bản tóm tắt sự thật được kiểm soát (giá gói tiêu chuẩn, kênh đang hỗ trợ, những gì không cung cấp như WhatsApp, chính sách biên tập). Nhưng chúng tôi không kỳ vọng nó cải thiện thứ hạng, và không ưu tiên nó hơn bất kỳ lớp nào ở trên.
Hạ tầng
Hạ tầng phía sau ảnh hưởng đến SEO thế nào?
Trang chậm hoặc lỗi thì không lớp nào ở trên cứu được. Website chạy Next.js trên một cụm Kubernetes gọn nhẹ (k3s), với quy trình xuất bản như sau:
Hai sự cố thực tế cho thấy hạ tầng tác động trực tiếp đến trải nghiệm và khả năng index:
- CPU bị bóp dù tải thấp. Mỗi lần render trang động tốn khoảng 150 ms CPU và chạy song song nhiều luồng. Với giới hạn 1 core, cơ chế CFS quota của Linux bóp CPU ở gần như mọi lần render (cảnh báo CPUThrottlingHigh ở mức khoảng 27%). Nâng giới hạn lên 2 core và chuyển health check từ trang
/vi(render đầy đủ, 8 lần mỗi phút mỗi pod) sang endpoint nhẹ/api/healthđã giải quyết vấn đề. Xem thêm website chậm dù CPU và RAM thấp. - Một tính năng CDN làm hỏng trang. Tính năng Email Address Obfuscation của Cloudflare viết lại địa chỉ email trong HTML và chèn script. Script này bị Content Security Policy chặn và làm React báo lỗi hydration (#418). Chúng tôi tắt tính năng này cho website production và ghi lại trong tài liệu vận hành.
Chi tiết về pipeline và giám sát có trong bài DevSecOps thực chiến cho website doanh nghiệp và từ Git push đến production.
Bài học
Những sai lầm chúng tôi đã phải sửa
- Bài trùng ý định tìm kiếm. Viết nhiều bài cho cùng một câu hỏi làm chúng cạnh tranh lẫn nhau. Cách sửa: gộp nội dung vào một bài mạnh nhất, chuyển hướng 301 các URL còn lại.
- Tác giả chung chung. "FlowNexa Team" không cho người đọc biết ai chịu trách nhiệm. Cách sửa: tác giả thật, trang hồ sơ, chính sách biên tập công khai.
- Ngày đăng bị "nhảy". Strapi 5 cập nhật
publishedAtmỗi lần publish lại, khiến bài cũ trông như mới đăng. Cách sửa: lưu riêng ngày đăng lần đầu và ngày cập nhật nội dung thực chất; chỉ hai giá trị này được dùng cho ngày hiển thị,dateModifiedvàlastmod. - Markdown hiện nguyên văn. Một số thẻ liên kết cuối bài hiển thị chuỗi
[Tiêu đề](https://…)thay vì đường link. Cách sửa: renderer tự nhận dạng và chuyển thành link nội bộ, không phải sửa từng bài. - Tính năng CDN xung đột với bảo mật. Như đã kể ở trên, mỗi tính năng "tối ưu tự động" của CDN cần được kiểm tra với CSP và framework đang dùng.
Đo lường
Làm sao biết những thay đổi này có hiệu quả?
Hiện chưa có công cụ chuẩn nào đo chính xác "độ hiện diện trong câu trả lời AI". Cách thực tế là kết hợp:
- Google Search Console: trạng thái index, lỗi sitemap, truy vấn và lượt hiển thị theo trang. Lưu lượng từ AI Overviews và AI Mode được tính chung vào báo cáo hiệu suất Search.
- Bing Webmaster Tools: xác nhận IndexNow hoạt động và theo dõi index trên Bing.
- Rich Results Test và Schema Markup Validator: kiểm tra JSON-LD sau mỗi thay đổi template.
- Kiểm tra thủ công định kỳ: đặt các câu hỏi mục tiêu trên ChatGPT, Perplexity, Gemini và ghi lại nguồn được trích dẫn.
- Nguồn giới thiệu trong analytics: khi bật analytics, theo dõi lượt truy cập đến từ các trợ lý AI.
Hỏi đáp
Câu hỏi thường gặp
Có cần thêm schema đặc biệt để xuất hiện trong AI Overviews không?
Không. Google cho biết không có schema.org đặc biệt nào cần thêm cho AI Overviews hay AI Mode. Dữ liệu có cấu trúc vẫn hữu ích cho Search nói chung, với điều kiện nó khớp với nội dung hiển thị trên trang.
llms.txt có giúp tăng thứ hạng không?
Không có bằng chứng cho điều đó. llms.txt là đề xuất cộng đồng, chưa phải tiêu chuẩn, và Google nói không cần file văn bản dành cho AI. Nếu tạo, hãy coi nó là bản tóm tắt sự thật có chi phí thấp, không phải công cụ SEO.
Có nên chặn crawler AI trong robots.txt không?
Tùy mục tiêu kinh doanh. Chặn crawler của một trợ lý AI nghĩa là nội dung khó được trợ lý đó trích dẫn. Nếu muốn được trích dẫn, hãy cho phép; nếu lo ngại nội dung bị dùng để huấn luyện, hãy tìm hiểu từng user-agent vì một số chỉ phục vụ tìm kiếm, một số phục vụ huấn luyện.
IndexNow có giúp Google index nhanh hơn không?
Không. Theo trang FAQ của IndexNow, các công cụ tham gia gồm Bing, Yandex, Naver, Seznam, Yep và Amazon; Google không có trong danh sách. Với Google, hãy dùng sitemap và Search Console.
Website song ngữ cần lưu ý gì nhất?
Mỗi ngôn ngữ một URL riêng, hreflang hai chiều giữa các bản, x-default rõ ràng và canonical trỏ về chính ngôn ngữ đó. Bản dịch nên được bản địa hóa thay vì dịch máy từng câu.
Doanh nghiệp nhỏ nên bắt đầu từ đâu?
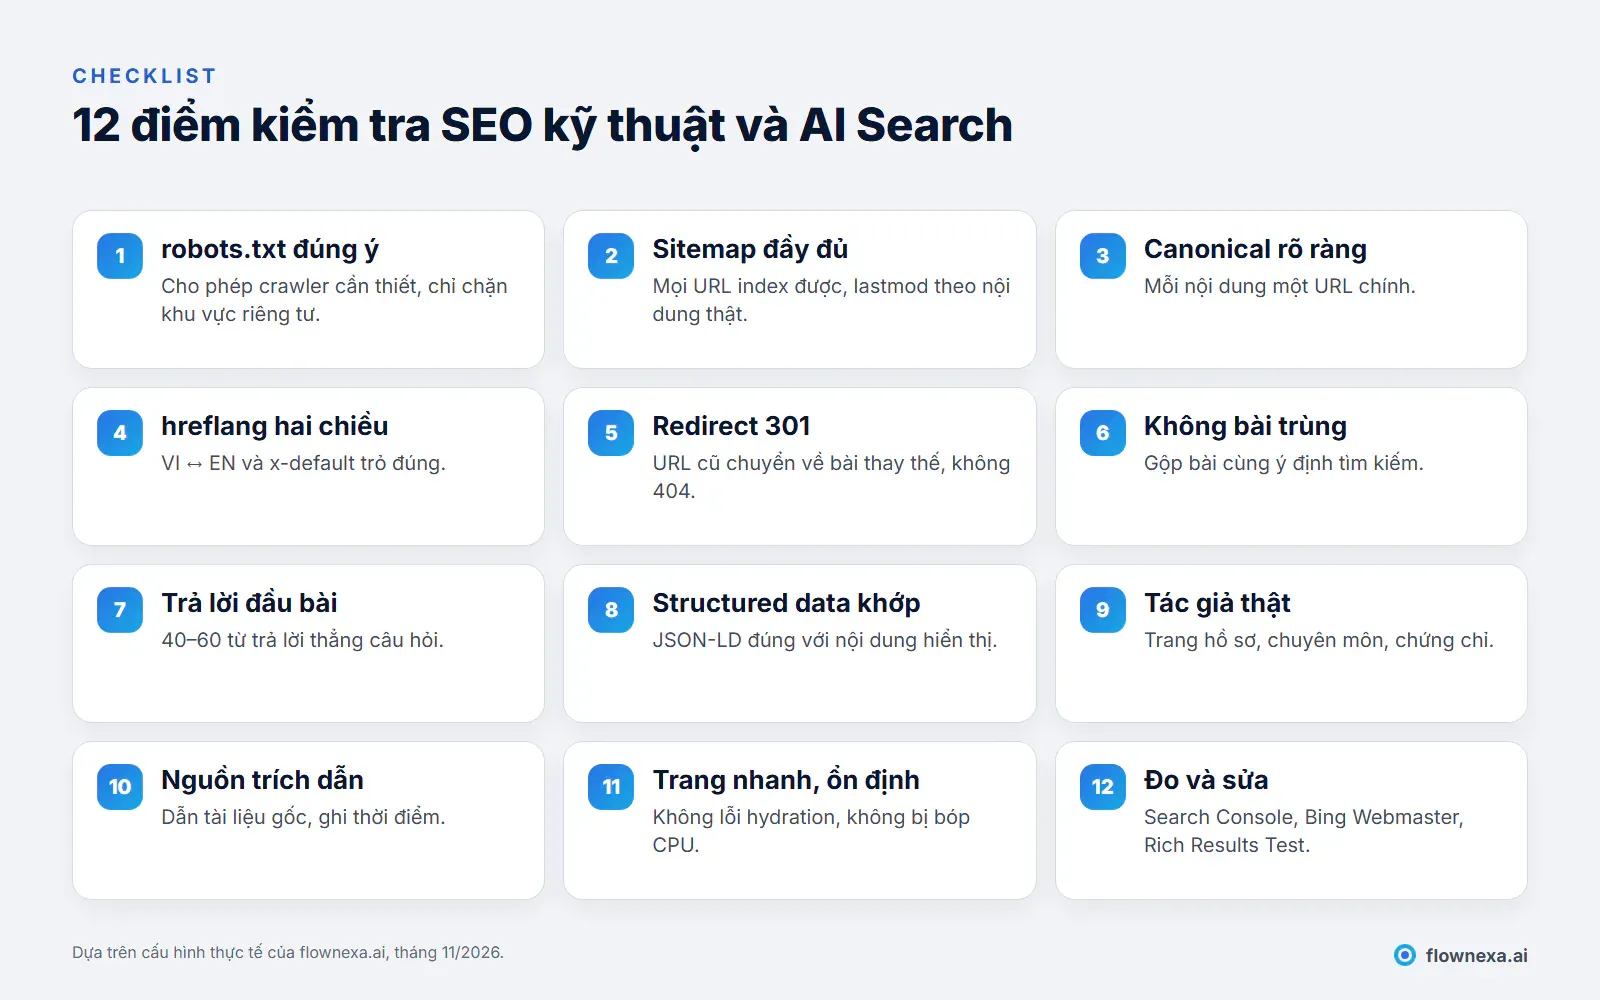
Từ lớp 1 và 2: kiểm tra robots.txt, sitemap, canonical và các trang lỗi 404 trong Search Console. Sau đó mới đến nội dung, dữ liệu có cấu trúc và tác giả. Checklist 12 điểm ở trên là thứ tự hợp lý để rà soát.
Nguồn tham khảo
- AI features and your website, Google Search Central
- Tell Google about localized versions of your page, Google Search Central
- IndexNow FAQ, danh sách công cụ tìm kiếm tham gia
- The /llms.txt file, đề xuất của Jeremy Howard (2024)
- Cấu hình thực tế của flownexa.ai (robots, sitemap, redirect, CI/CD, Kubernetes) tại thời điểm viết, tháng 11/2026
FlowNexa
Rà soát website doanh nghiệp của bạn
FlowNexa kiểm tra crawl, index, dữ liệu có cấu trúc, hiệu năng và quy trình triển khai, rồi đề xuất thứ tự sửa theo mức ảnh hưởng.
CI/CD có kiểm soát chất lượng, giám sát và cảnh báo cho website.
Kubernetes, k3s và hạ tầng phù hợp quy mô doanh nghiệp.
Trao đổi về website và mục tiêu tìm kiếm của bạn.
